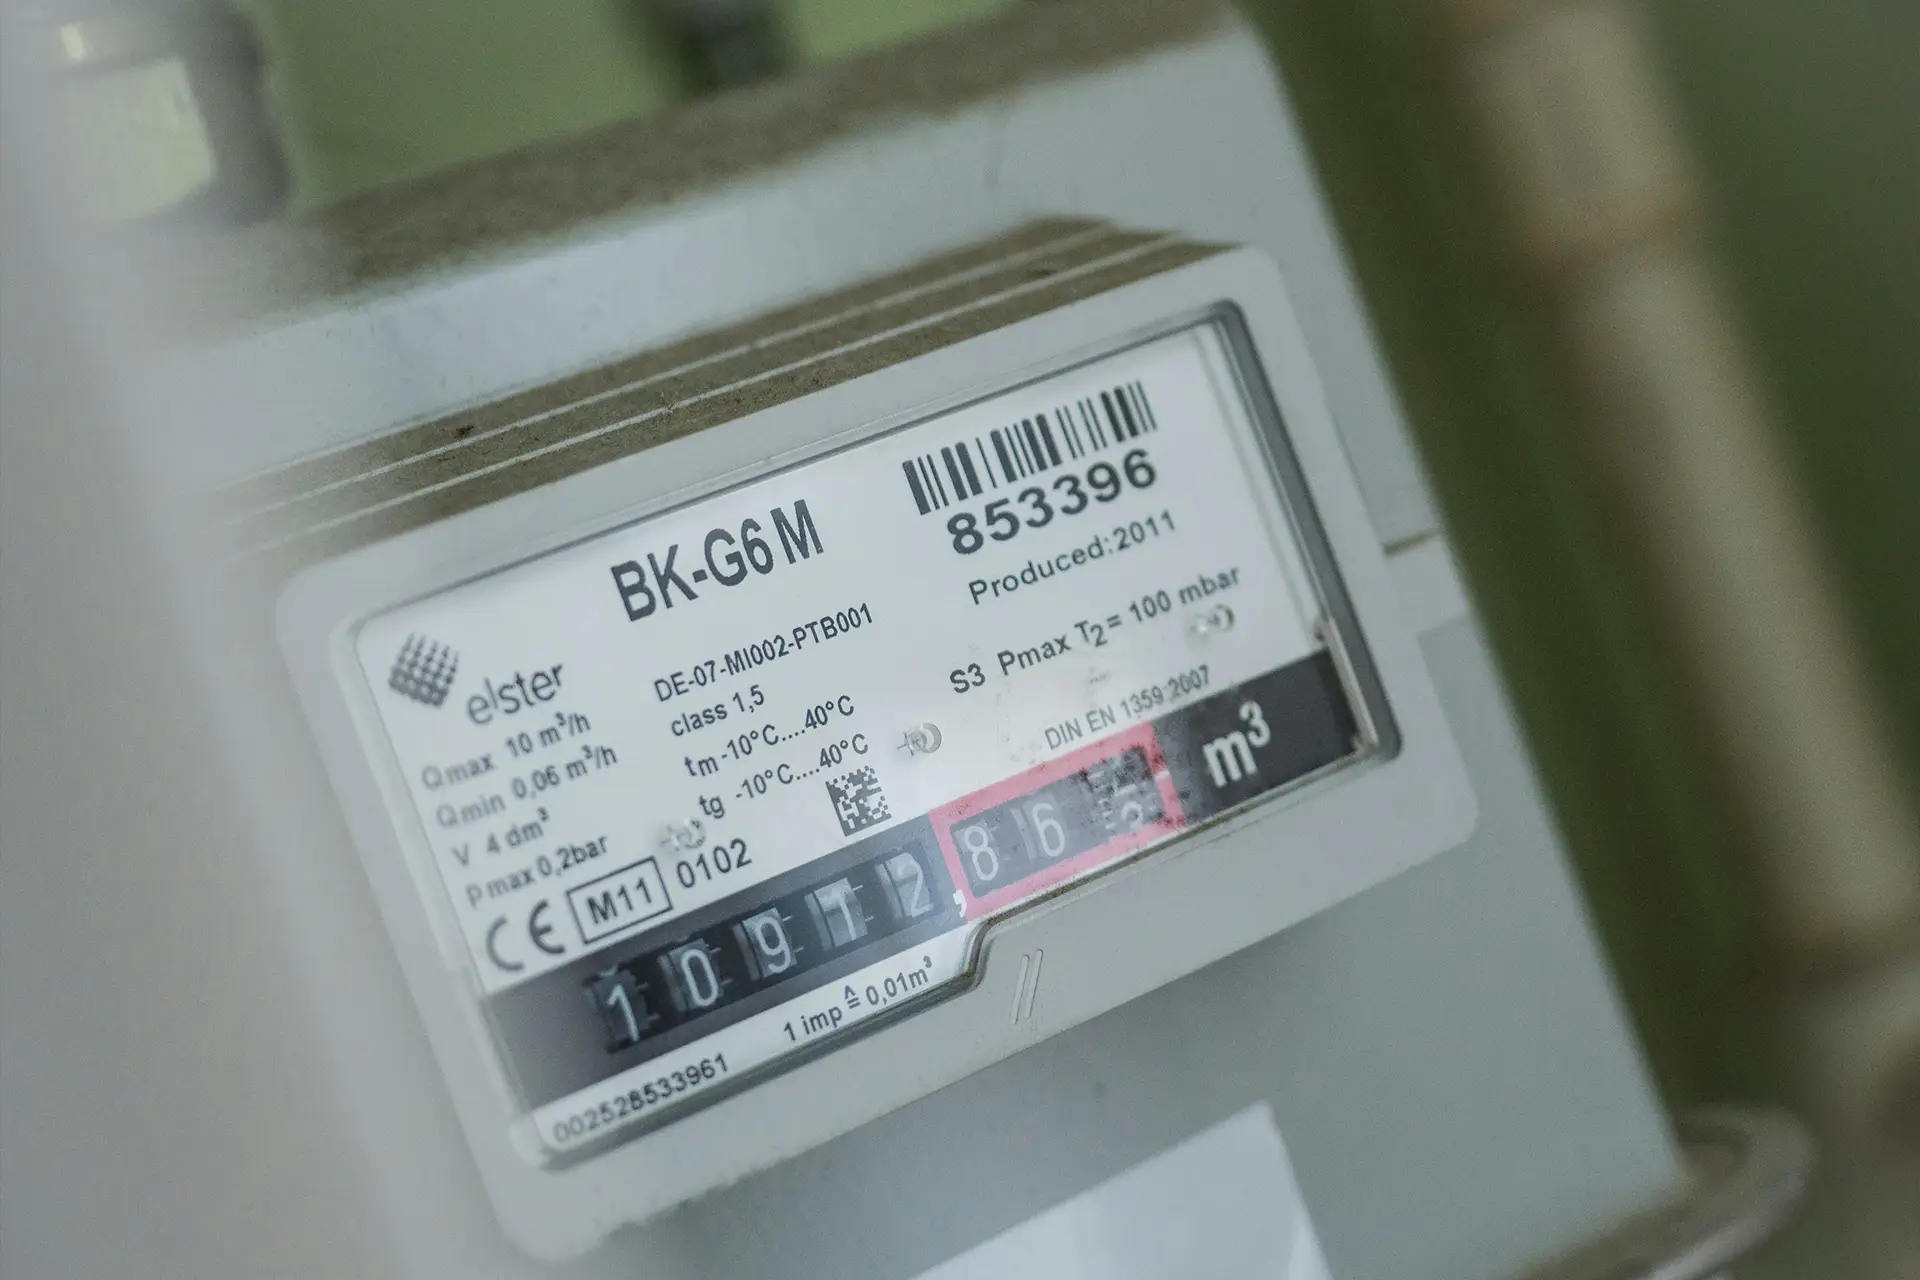


Nous avons personnalisé un modèle de détection d'objets pour la lecture de compteurs analogiques.

Nous avons mis en place un pipeline de développement d'IA et d'inférence par lots sur Databricks.
Nous avons configuré l'ingestion automatique de données provenant d'un système de caméra basse consommation unique.

Notre client est une entreprise technologique européenne qui fournit une plateforme de suivi énergétique aux organisations gérant plusieurs bâtiments. Nombre de leurs clients utilisent encore des compteurs d'eau et de gaz analogiques traditionnels, dont le remplacement est coûteux. Pour combler cette lacune, notre client a développé un système de caméra basse consommation ingénieux qui photographie ces compteurs à distance.
Cependant, la conception basse consommation du système a créé un obstacle en matière de données : les caméras produisent images difficiles et de faible qualité prises sous un angle. Les outils de lecture automatisés standards comme l'OCR ne parvenaient pas à extraire de manière fiable les valeurs des compteurs à partir de ces données visuelles. Le client nous a sollicités pour créer une solution d'IA sur mesure capable d'interpréter avec précision ces images spécifiques pour sa plateforme.


Notre client peut désormais automatiquement et de manière fiable lire les compteurs d'eau et de gaz analogiques à partir d'images complexes, éliminant ainsi le besoin de processus manuels coûteux et de déplacements sur site. Les données des compteurs sont transmises directement à leur plateforme, le modèle d'IA assurant un suivi constant des relevés et gérant les problèmes de qualité d'image ainsi que les ambiguïtés de chiffres sans intervention humaine.
En conséquence, notre client réalise d'importantes économies de temps et de frais opérationnels, tandis que ses clients finaux bénéficient d'un suivi de consommation précis et actualisé, ainsi que d'un système évolutif prêt à gérer des milliers d'appareils.
Propulsé par


Notre objectif pour ce projet était clair : nous devions fournir une preuve de concept (PoC) fonctionnelle rapidement, tout en nous appuyant sur une base solide capable de soutenir une croissance future.
Le client utilisait déjà Microsoft Azure pour ses opérations. La décision a donc été simple : nous allions concevoir la solution au sein de leur environnement existant. Cette approche a permis de simplifier les choses et de faciliter le suivi des coûts.
Nous avons mis à profit notre expérience des plateformes d'apprentissage automatique intégrées pour recommander Databricks. Cela leur a offert un espace de travail unifié où ils pouvaient traiter les données, affiner les modèles, gérer l'entraînement et tout suivre grâce à MLflow et Unity Catalog. Cette configuration a considérablement accéléré les cycles de développement, ce qui est particulièrement pratique pour tester des preuves de concept.
Le une expertise métier approfondie et la proactivité de l'équipe du client ont été des facteurs déterminants dans la réussite du projet. Par exemple, notre première analyse a révélé que les images brutes nécessitaient une correction de perspective pour être exploitables. Leurs experts ont immédiatement pris en charge cette tâche de prétraitement eux-mêmes. Ils ont également géré l'étape cruciale de l'étiquetage des données d'image, indispensable à l'entraînement du modèle d'IA.
Cette forte implication du client nous a permis de nous concentrer exclusivement sur le système d'IA. Le projet a ainsi progressé bien plus rapidement . Une collaboration vraiment efficace !
Nos premiers tests ont rapidement confirmé que les techniques d'OCR classiques ne seraient pas assez performantes sur ces images. La faible qualité, l'angle de prise de vue et la manière dont les chiffres défilent sur les compteurs analogiques (affichant parfois des fragments de deux chiffres simultanément) représentaient des obstacles trop importants. Nous avons donc opté pour une autre approche : la détection d'objets via le modèle éprouvé YOLO (You Only Look Once).
Nous avons spécifiquement entraîné YOLO à détecter les chiffres de 0 à 9 sur les images des compteurs. Cette méthode s'est avérée bien plus adaptée pour plusieurs raisons :
L'entraînement du modèle a été (comme toujours avec l'IA et le ML) un cycle itératif. Nous avons commencé avec les données étiquetées pour entraîner les modèles initiaux. Le client a ensuite évalué les performances en reportant les relevés prédits sur son tableau de bord et en vérifiant visuellement l'absence de résultats étranges ou d'anomalies. Il a ensuite fourni de nouvelles données étiquetées, que nous avons utilisées pour réentraîner le modèle. À chaque cycle, la précision du modèle s'est améliorée de manière constante.
Pour le PoC, nous avons mis en place un pipeline de traitement par lotssimple :
Le client récupère ensuite ces données brutes depuis la base de données et applique sa propre logique de post-traitement qui assemble le relevé final du compteur. En utilisant les données de localisation et de confiance issues de notre modèle, ils peuvent interpoler les chiffres manquants ou gérer les détections incertaines en s'appuyant sur leur expertise métier.
Cette première phase visait à valider le concept avec succès pour un type de compteur spécifique dans un environnement contrôlé. Cependant, l'architecture que nous avons choisie et notre approche collaborative constituent une base solide pour la suite.
Nous avons déjà évoqué les prochaines étapes avec le client. Celles-ci incluent des stratégies pour gérer divers autres types de compteurs analogiques, peut-être en entraînant des modèles spécifiques pour chaque type ou en affinant un modèle général. Nous avons également discuté de la création d'un processus d'intégration pour les nouveaux compteurs, alors qu'ils se préparent à déployer potentiellement leurs caméras sur des milliers d'unités.
À la recherche d'une solution d'IA sur mesure capable de transformer des données complexes en informations exploitables ? Contactez-nous, nous serons ravis de vous aider !