

HiveMQ prend en charge deux voies d'ingestion vers Azure : Extension Datalake pour le stockage par lots et extension Kafka pour le streaming en temps réel

Un pipeline ETL utilisant Delta Live Tables transforme les données brutes « bronze » en jeux de données structurés de niveau argent ou or, prêts pour l'analyse.
L'interface SQL Warehouse de Databricks permet d'exposer les Delta Live Tables traitées vers Power BI, créant un pont entre les données IoT brutes et l'analyse métier


Propulsé par


Transformer des messages MQTT en informations exploitables nécessite bien plus qu'un simple broker. Il faut un pipeline de bout en bout, de l'ingestion à la transformation, jusqu'à la visualisation. Dans notre entreprise, nous avons exploré deux flux de données principaux pour intégrer HiveMQ à Azure et, in fine, à Power BI :
Les deux méthodes acheminent les données vers Databricks pour une transformation structurée avant d'atteindre les tableaux de bord Power BI. Le meilleur choix dépend de votre cas d'usage, mais aussi des coûts, de la latence et de la flexibilité. Un aperçu des deux méthodes et de leur flux de données est présenté ci-dessous.
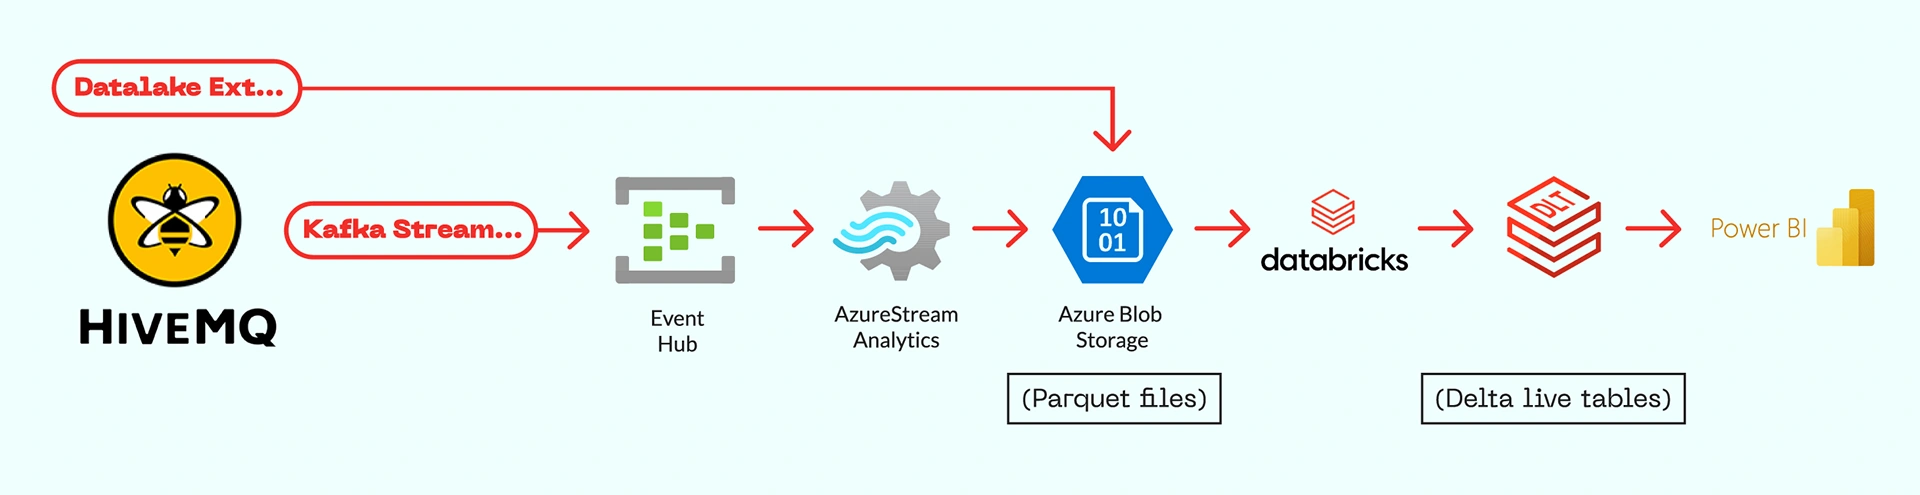
L'extension Datalake de HiveMQ facilite la capture du trafic MQTT et son stockage direct sous forme de fichiers Parquet dans Azure. Cette configuration est parfaitement adaptée à l'analyse historique et à l'exploration périodique des données. Cependant, deux points importants sont à noter :
Cela la rend idéale pour les scénarios où la latence n'est pas critique, mais où l'archivage structuré et la transformation en aval sont nécessaires.
L'extension Kafka permet à HiveMQ de transférer des messages MQTT en temps réel en utilisant le protocole Kafka. Lorsqu'elle est connectée à Azure Event Hub (niveau Standard), cela permet le streaming en temps réel vers l'écosystème Azure.
Avec Stream Analytics, les événements MQTT entrants peuvent être traités instantanément et écrits dans des fichiers Parquet.
Comparé à l'extension Datalake :
Cette architecture privilégie les cas d'usage nécessitant des analyses à faible latence, une surveillance opérationnelle ou des alertes.
Que les données soient ingérées via l'extension Datalake ou diffusées en continu via Event Hub, elles finissent sous forme de fichiers Parquet bruts dans le stockage Azure. Ces fichiers sont considérés comme des données de niveau bronze: ils contiennent tous les événements, mais restent non structurés et non filtrés.
Dans Databricks, nous avons construit un pipeline ETL utilisant Delta Live Tables (DLT) pour traiter ces données. Cette étape de transformation comprend :
Le résultat de cet ETL est considéré comme des données de niveau argent ou or, prêtes à être utilisées dans des outils de prise de décision, d'analyse et de visualisation comme Power BI.
Une fois les Delta Live Tables créées dans Databricks, elles peuvent être exposées à Power BI via l'interface SQL Warehouse de Databricks. Cela permet aux utilisateurs de créer tableaux de bord interactifs directement sur des jeux de données sélectionnés, sans pipelines ni exportations supplémentaires.
Le résultat est un pont fluide entre les données IoT brutes et l'analyse métier : les données MQTT transitent de HiveMQ vers Azure, sont enrichies et structurées dans Databricks, puis visualisées dans Power BI. Que vous surveilliez l'état d'une usine ou que vous génériez des rapports sur la consommation d'énergie, ce flux vous offre une vision complète, de la périphérie jusqu'à l'analyse.
Une transformation clé effectuée dans Databricks est le pivot du format étroit vers le format large:
La plupart des pipelines d'ingestion (Kafka, Datalake) fournissent des données au format étroit. Cependant, les outils de BI comme Power BI et Grafana fonctionnent mieux avec des tables au format large. L'étape ETL gère ce remodelage, rendant les données plus intuitives et performantes pour les utilisateurs finaux.
Ces deux architectures sont performantes. L'extension Datalake excelle par sa simplicité et ses capacités d'archivage. L'extension Kafka, quant à elle, offre des fonctionnalités en temps réel et un pipeline de streaming plus flexible, le tout sans nécessiter de licence coûteuse.
Pour les entreprises cherchant à connecter l'IoT industriel au reporting d'entreprise, HiveMQ, Azure et Databricks offrent une pile technologique robuste et évolutive.
Curieux de voir comment cela fonctionne avec Ignition comme plateforme de base ? Découvrez notre article connexe : "D'Ignition à Power BI : diffusion de données IoT en continu avec Azure et Databricks"