
Appliquez la gouvernance et la structure des données pour éviter le chaos dans votre Unified Namespace.

Transformez et contextualisez les données brutes à la volée grâce à des modèles et des pipelines intelligents.
Intégrez facilement d'autres outils haut de gamme pour servir de couche d'intelligence centrale.

HighByte Intelligence Hub est une plateforme DataOps industrielle, conçue spécifiquement pour la modélisation, l'orchestration et la gouvernance des données industrielles.
Elle agit comme une couche d'intelligence dans l'architecture des données de votre usine, se situant entre vos systèmes OT et les applications qui consomment ces données.
Il s'agit d'une solution edge-native sans code qui collecte, modélise et transmet en toute sécurité des charges utiles aux applications cibles dans toute votre entreprise.
Alors que la plupart des outils de connectivité se concentrent sur le transfert de données d'un point A à un point B, HighByte ajoute une couche dédiée pour modéliser, standardiser et contextualiser ces données avant qu'elles n'atteignent leur destination : un Unified Namespace, un historien, une plateforme cloud ou une application d'analyse.


Nous positionnons HighByte dans les architectures où les clients ont besoin d'une intelligence de données avancée de niveau entreprise, tout en privilégiant une approche « best-of-breed ». Par exemple, vous pouvez utiliser Ignition pour sa vaste connectivité aux appareils, et ajouter HighByte par-dessus pour gérer la modélisation et la gouvernance avant que les données n'intègrent l'architecture globale.
HighByte dispose également d'une intégration native avec la plateforme Ignition d'Inductive Automation, ce qui en fait un choix naturel pour nos projets. C'est particulièrement pertinent dans les déploiements complexes d'Unified Namespace où plusieurs équipes alimentent un broker partagé, et où une couche de gouvernance imposant des schémas est indispensable.
La même logique s'applique lors de l'association de HighByte avec Tulip. Tulip numérise la couche opérateur en atelier, et HighByte s'intercale pour contextualiser et gouverner les données dans les deux sens. Il achemine les données des opérateurs vers l'UNS et renvoie des données contextualisées vers les applications Tulip.

Vous construisez une architecture de données complexe et de niveau entreprise ? Voici pourquoi HighByte Intelligence Hub mérite votre attention.
HighByte vous permet de créer des modèles pour standardiser et contextualiser les points de données bruts, de configurer des pipelines de données et d'appliquer une gouvernance via des règles. Il normalise les variables entre différentes machines pour pallier les structures d'appareils incohérentes.
Vous pouvez également appliquer de la logique, des seuils de tolérance (deadbands) et des calculs à la volée pour réduire le bruit et transformer les entrées brutes. Ainsi, vous avez la garantie que vos données sont parfaitement contextualisées avant même d'atteindre votre base de données ou vos modèles d'IA.
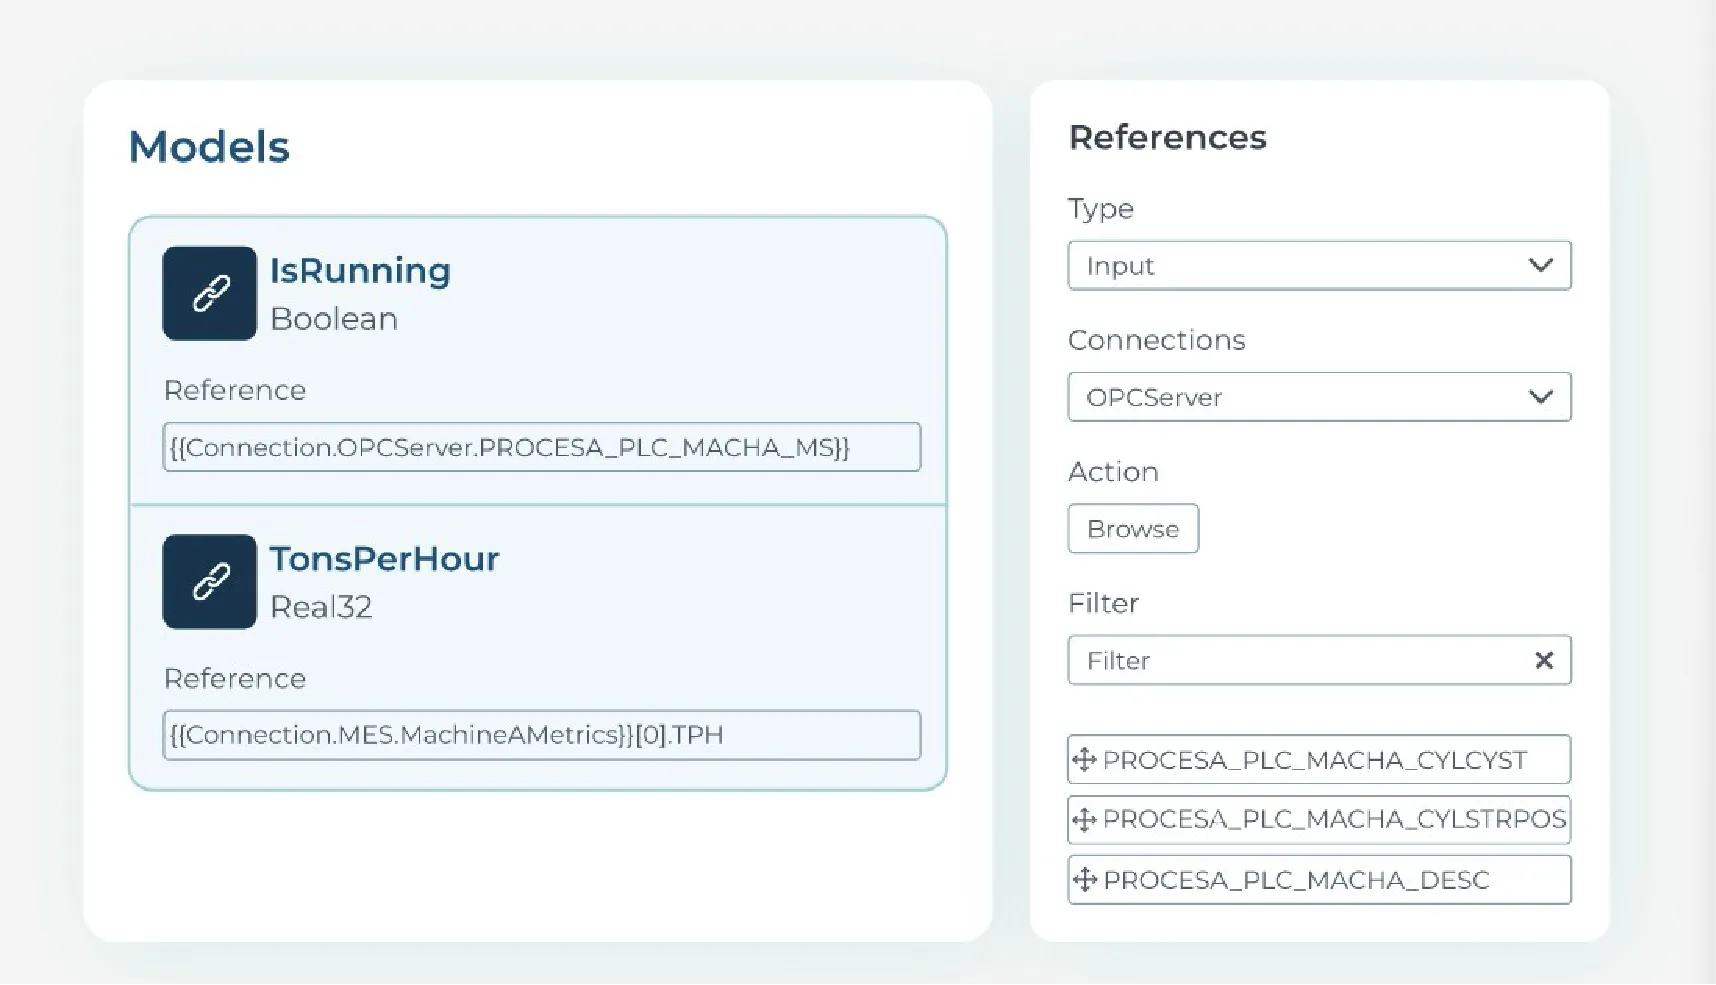
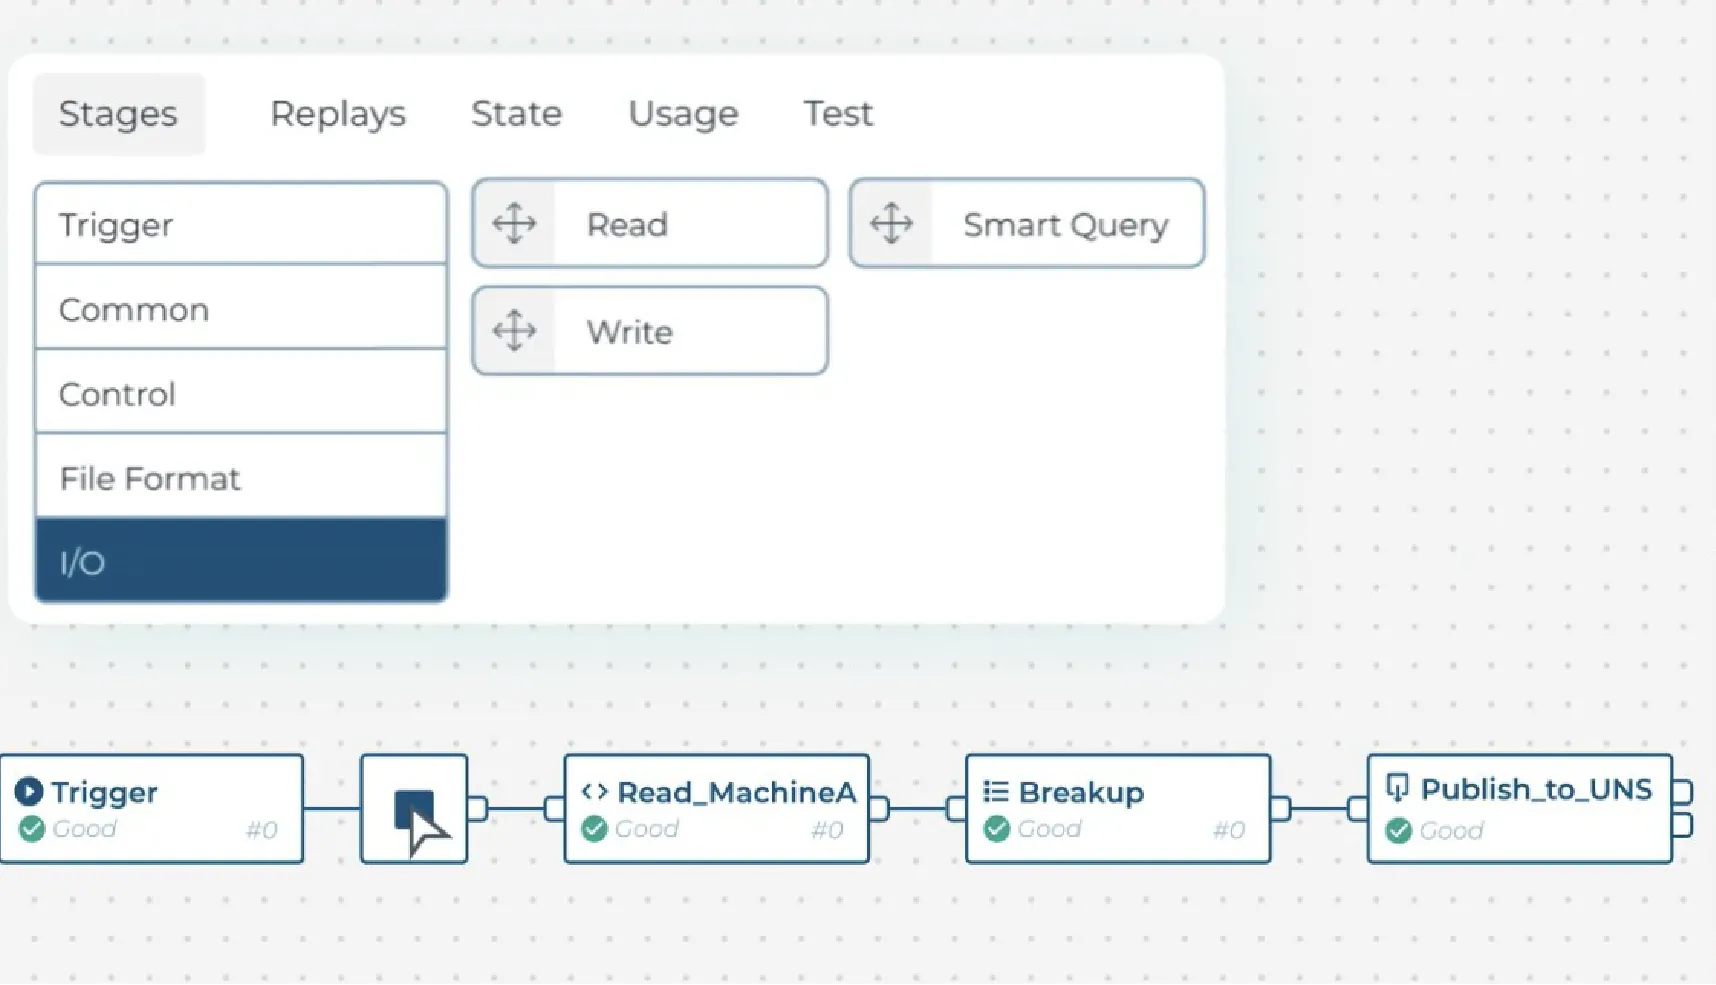
HighByte élimine le besoin de code sur mesure ou de dépannage d'intégrations défaillantes. Son interface graphique vous permet de construire des pipelines qui filtrent, mettent en mémoire tampon et transforment les charges utiles spécifiquement pour le système qui les consomme.
Grâce aux connexions natives avec des outils comme Ignition, les brokers MQTT, AWS, Snowflake et TimescaleDB, vous pouvez acheminer les données entre vos couches OT et IT sans écrire une seule ligne de code d'intégration spécifique.
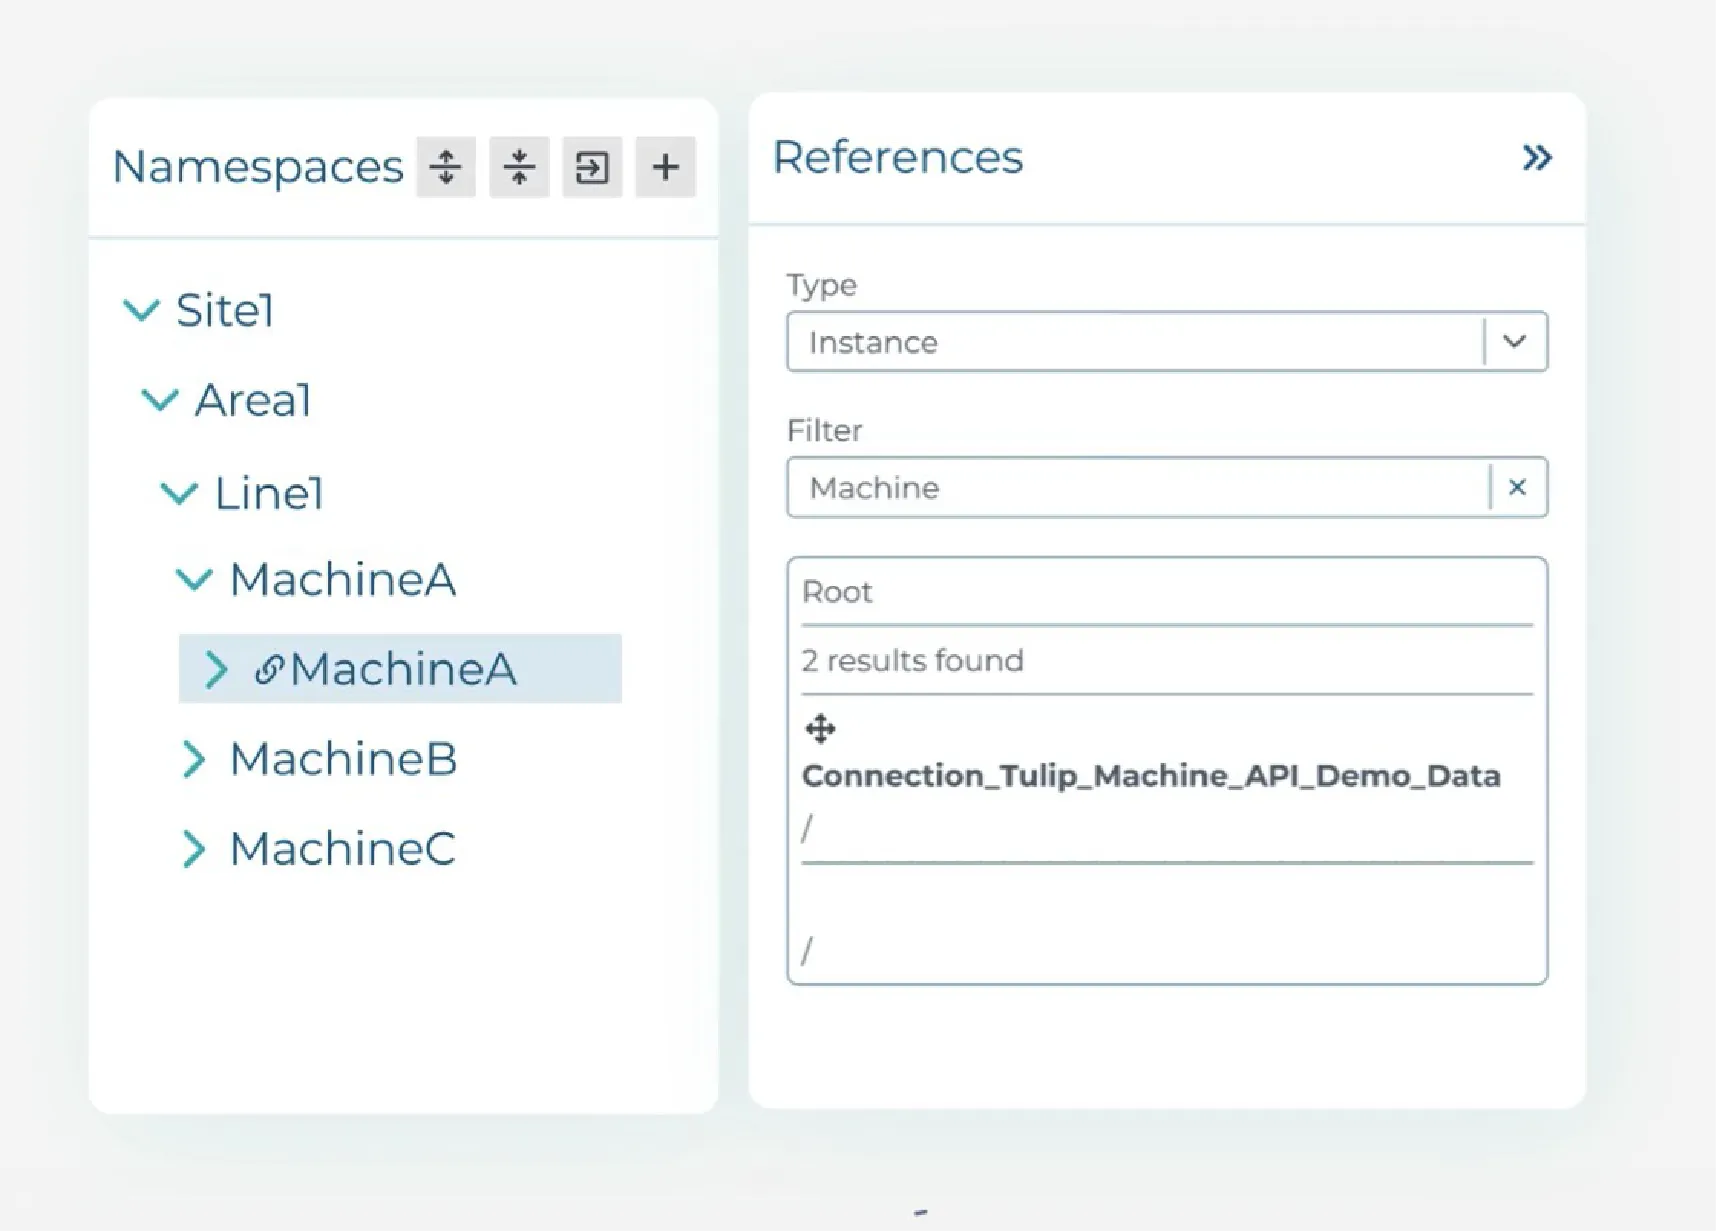
Si vous déployez un Unified Namespace (UNS), HighByte peut servir de centre de commande. Sa fonctionnalité dédiée d'espaces de noms et sa fonction de requête intelligente vous offrent un espace visuel pour concevoir et appliquer votre hiérarchie de données.
Vous pouvez exécuter des requêtes sur l'ensemble de l'espace de noms et vérifier que chaque point de données respecte les règles structurelles de votre organisation avant qu'il n'atteigne le broker d'entreprise.
Pour les secteurs réglementés tels que les sciences de la vie et les services publics, HighByte propose un mode Haute Disponibilité dédié. Dans ce mode, Intelligence Hub synchronise en continu la configuration et l'état entre les environnements d'exécution via une base de données PostgreSQL partagée. Lorsqu'un hub principal devient indisponible, le hub secondaire prend le relais en ayant une connaissance complète de la configuration et de l'activité des pipelines les plus récentes.
Combinez le mode Haute Disponibilité avec d'autres fonctionnalités telles que l'audit intégré, l'accès basé sur les rôles et l'intégration Git pour le contrôle de version, et vous obtenez la traçabilité et la sécurité requises pour les environnements fortement réglementés.
Récemment, HighByte a introduit un serveur MCP industriel intégré, qui expose les pipelines de données en tant qu'outils pour les agents IA. Les agents IA peuvent l'utiliser pour accéder en toute sécurité à tous les systèmes connectés et effectuer des demandes de données en temps réel ou historiques directement via Intelligence Hub.
Intelligence Hub prend également en charge la contextualisation des données assistée par LLM via des connexions natives à Amazon Bedrock, Azure OpenAI et Google Gemini, ce qui accélère considérablement le travail de modélisation pour les déploiements à grande échelle. Si vous cherchez à utiliser l'IA en toute sécurité, nous vous recommandons d'y jeter un œil.

HighByte propose un essai gratuit d'Intelligence Hub. Il est facile à installer sur du matériel léger (Windows, macOS ou Linux) ou vous pouvez simplement le déployer en tant que conteneur Docker.
L'essai se réinitialise toutes les deux heures, mais vous pouvez le redémarrer un nombre illimité de fois. Une fois que vous êtes prêt à passer au-delà des tests, nous sommes là pour vous aider à l'intégrer en toute sécurité.

Téléchargez notre testeur de broker MQTT gratuit et vérifiez si votre infrastructure MQTT est prête pour la production.

Le DataOps industriel peut être difficile à appréhender au début, mais le Resource Hub de HighByte propose d'excellents guides et supports, tant sur leur propre produit que sur le DataOps en général.
Nous vous recommandons de consulter tout particulièrement les ressources suivantes :